Ir para o conteúdo

Black Friday: até 61% de desconto nos nossos packs até 30 de novembro.

Ver os packs

Blog

Blog e perspetivas

Artigos práticos sobre como criar e operar produtos, agentes e fluxos de trabalho de IA.

Todos os artigos

    • Cloud e infraestrutura

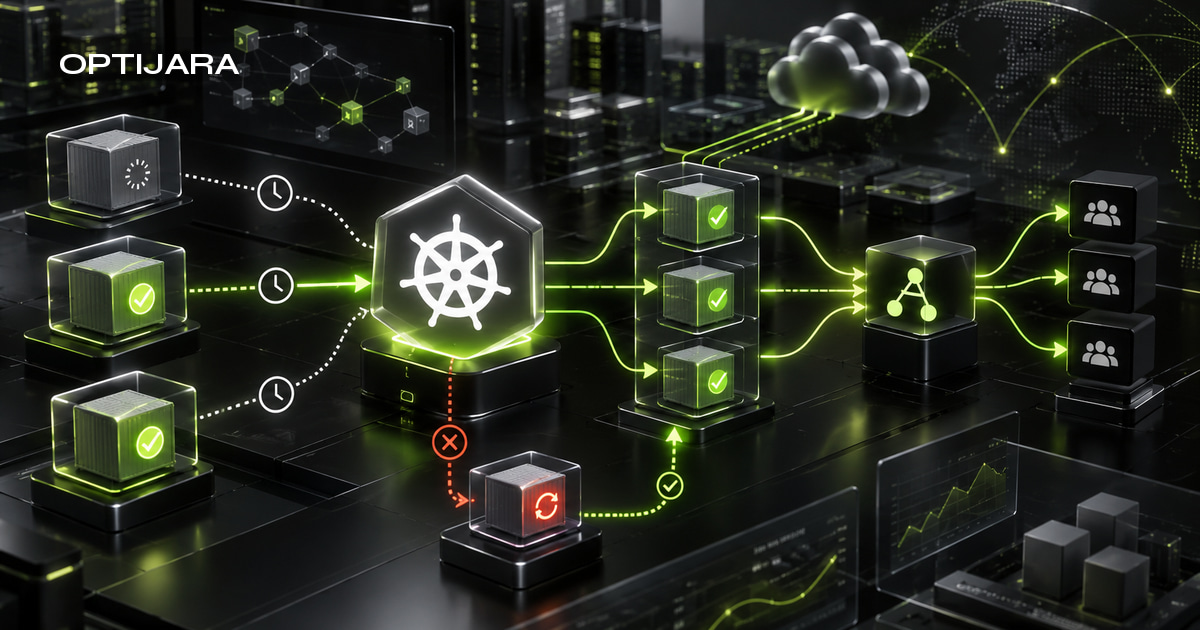
    Sondas do Kubernetes: quando esperar, encaminhar tráfego ou reiniciar

    As sondas de inicialização, prontidão e vitalidade respondem a perguntas operacionais diferentes. Utilize uma matriz de decisão, contratos explícitos de endpoints e um plano proposto de testes de falhas em pré-produção para escolher quando uma aplicação deve esperar, sair da rotação de tráfego ou reiniciar.

    • Cloud e infraestrutura

    Vercel AI Gateway: um playbook de produção para roteamento, observabilidade, orçamentos e controle de provedores

    O Vercel AI Gateway pode oferecer às equipes de produtos de IA uma camada de controle para acesso a modelos, roteamento, observabilidade, orçamentos e políticas de provedores. Este playbook explica quando essa camada ajuda, o que testar antes da migração e onde integrações diretas com provedores ainda podem ser a melhor opção.

    • Cloud e infraestrutura

    Pontuacoes de benchmark precisam de protocolos: como Evaluation Cards e Every Eval Ever tornam resultados de IA comparaveis

    O lancamento de 22 de setembro do UK AISI e da EvalEval aponta para uma forma mais util de ler benchmarks de IA: conectar a pontuacao ao protocolo antes de comparar modelos. Este guia explica como Evaluation Cards, Every Eval Ever e registros publicos de escalonamento de inferencia podem apoiar comparacoes rastreaveis sem fingir que a validacao de esquema torna os experimentos equivalentes.

    • Cloud e infraestrutura

    Optimum Intel 2.2 e OpenVINO GenAI 2026.4: um mapa de temporização da codificação à decodificação para inferência multimodal

    Optimum Intel 2.2 e OpenVINO GenAI 2026.4 são mais úteis quando tratados como uma melhoria de observabilidade, não como uma melhoria cega de desempenho. Este guia mapeia exportação, quantização, runtime, codificação, pré-preenchimento, decodificação, batching e posicionamento do Qwen3-Omni em uma estrutura prática para operadores.

    • Cloud e infraestrutura

    d-Matrix Raptor e NVIDIA NVLink Fusion: um mapa de posicionamento das fases de inferência para racks heterogêneos

    A d-Matrix e a NVIDIA anunciaram uma colaboração de roteiro envolvendo Raptor, NVLink Fusion, MGX, CPUs Vera, Spectrum-X e conectividade da Astera Labs. O ponto útil hoje não é uma alegação de benchmark, mas um mapa de medição para decidir onde o pré-preenchimento, a transferência de estado e a decodificação devem rodar em futuros racks heterogêneos de inferência.

    • Cloud e infraestrutura

    WeatherNext 3 e o teste de atualidade da previsão para sistemas de decisão operacional

    WeatherNext 3 leva previsões meteorológicas com IA por hora e de maior resolução para interfaces que os operadores já usam, mas melhores dados meteorológicos não criam automaticamente melhores decisões. Este artigo apresenta o Teste de Atualidade da Previsão e Decisão da Optijara para decidir quando previsões com IA são recentes, locais, confiáveis e seguras o suficiente para influenciar fluxos de trabalho operacionais.

    • Cloud e infraestrutura

    Teste de Aceitação de Rota de Previsão TimesFM-3: quando um modelo multivariado zero-shot está pronto para operações

    O Google Research posiciona o TimesFM-3 como um modelo de base de previsão multivariada zero-shot, mas a aceitação em produção é uma decisão no nível da rota. A estrutura FRAT da Optijara testa proveniência de artefatos, covariáveis, vazamento, calibração, linhas de base, controles de canário, reversão e limites de licença antes que uma rota de previsão mude.

    • Cloud e infraestrutura

    Engenharia de desempenho de IA: uma escada de evidências de desempenho da GPU à produção para gargalos de inferência

    Serviços de inferência em GPU podem parecer ocupados enquanto os usuários ainda esperam, as novas tentativas aumentam ou a taxa de tarefas aceitas fica abaixo do esperado. Este artigo transforma o mapa de recursos AI Performance Engineering V2 na Performance Evidence Ladder da Optijara, um método reproduzível para diagnosticar gargalos de inferência desde rastreamentos de solicitações até evidências de serviço distribuído.

Próximo passo

Tem algo para construir?

Diga-nos do que precisa. Respondemos com um âmbito claro e um orçamento fechado.