Aller au contenu

Black Friday : jusqu’à 61 % de remise sur nos packs jusqu’au 30 novembre.

Voir les packs

Blog

Blog et analyses

Des articles pratiques pour concevoir et exploiter des produits, des agents et des workflows IA.

Tous les articles

    • Cloud et infrastructure

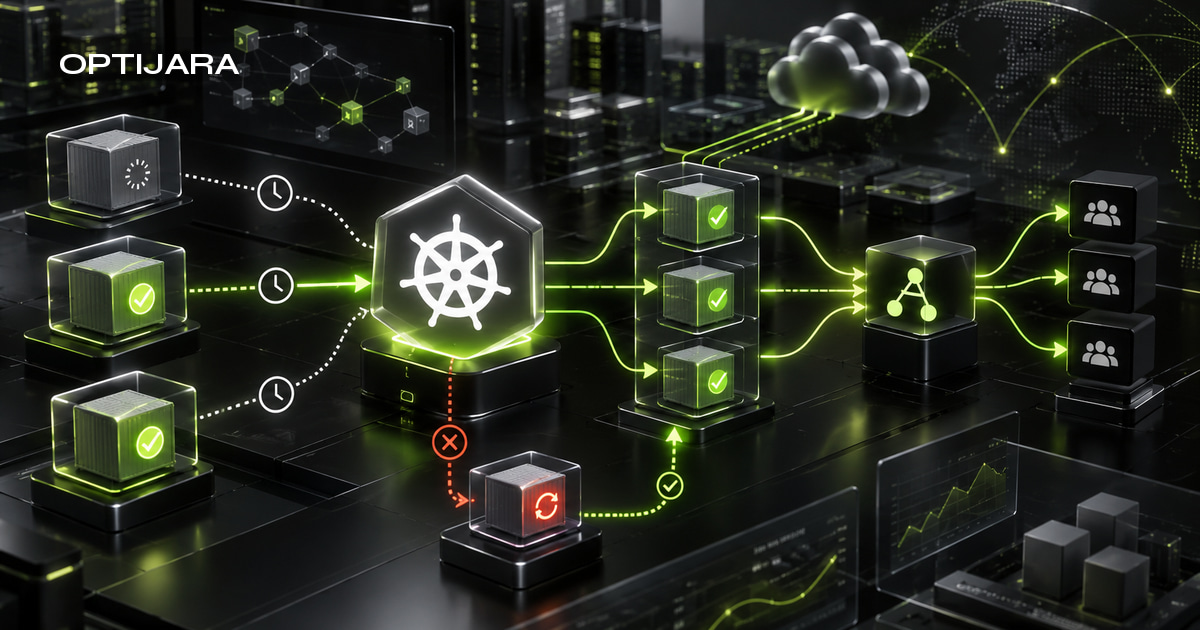
    Sondes Kubernetes : quand attendre, acheminer le trafic ou redémarrer

    Les sondes de démarrage, de disponibilité et de vivacité répondent à des questions opérationnelles différentes. Utilisez une matrice de décision, des contrats explicites pour les points de terminaison et un plan proposé de tests de défaillance en préproduction pour choisir quand une application doit attendre, être retirée du trafic ou redémarrer.

    • Cloud et infrastructure

    Vercel AI Gateway : guide de production pour le routage, l'observabilité, les budgets et le contrôle des fournisseurs

    Vercel AI Gateway peut offrir aux équipes produit IA une couche de contrôle pour l'accès aux modèles, le routage, l'observabilité, les budgets et la politique fournisseur. Ce guide explique quand cette couche est utile, ce qu'il faut tester avant une migration et dans quels cas les intégrations directes avec les fournisseurs peuvent rester plus adaptées.

    • Cloud et infrastructure

    Les scores de benchmarks ont besoin de protocoles : comment Evaluation Cards et Every Eval Ever rendent les résultats d'IA comparables

    La publication du 22 septembre par UK AISI et EvalEval montre une façon plus utile de lire les benchmarks d'IA : rattacher le score au protocole avant de comparer les modèles. Ce guide explique comment Evaluation Cards, Every Eval Ever et les enregistrements publics de mise à l'échelle de l'inférence peuvent soutenir une comparaison traçable sans prétendre que la validation de schéma rend les expériences équivalentes.

    • Cloud et infrastructure

    Optimum Intel 2.2 et OpenVINO GenAI 2026.4 : une carte temporelle de l'encodage au décodage pour l'inférence multimodale

    Optimum Intel 2.2 et OpenVINO GenAI 2026.4 sont surtout utiles lorsqu'on les traite comme une amélioration de l'observabilité, et non comme une amélioration aveugle des performances. Ce guide cartographie l'export, la quantification, le runtime, l'encodage, le prefill, le décodage, le batching et le placement de Qwen3-Omni dans un cadre pratique pour les équipes d'exploitation.

    • Cloud et infrastructure

    d-Matrix Raptor et NVIDIA NVLink Fusion : une carte de placement des phases d'inférence pour baies hétérogènes

    d-Matrix et NVIDIA ont annoncé une collaboration de feuille de route autour de Raptor, NVLink Fusion, MGX, des CPU Vera, de Spectrum-X et de la connectivité Astera Labs. L'enseignement utile aujourd'hui n'est pas une revendication de mesure de performance, mais une carte de mesure pour décider où le préremplissage, le transfert d'état et le décodage doivent s'exécuter dans de futures baies d'inférence hétérogènes.

    • Cloud et infrastructure

    WeatherNext 3 et le test de fraîcheur des prévisions pour les systèmes de décision opérationnelle

    WeatherNext 3 apporte des prévisions météo IA horaires et à plus haute résolution dans des interfaces que les opérateurs utilisent déjà, mais de meilleures données météo ne produisent pas automatiquement de meilleures décisions. Cet article présente le test Optijara de fraîcheur des prévisions et de décision pour déterminer quand des prévisions IA sont assez fraîches, locales, fiables et sûres pour influencer les flux de travail opérationnels.

    • Cloud et infrastructure

    Test d'acceptation de route de prevision TimesFM-3 : quand un modele multivarie zero-shot est pret pour les operations

    Google Research presente TimesFM-3 comme un modele fondationnel multivarie zero-shot pour la prevision, mais l'acceptation en production se decide au niveau de la route. Le cadre FRAT d'Optijara teste la provenance des artefacts, les covariables, les fuites, l'etalonnage, les references, les controles canari, le rollback et les limites de licence avant qu'une route de prevision change.

    • Cloud et infrastructure

    Ingenierie des performances IA : une echelle de preuves de performance du GPU a la production pour les goulots d'etranglement d'inference

    Les services d'inference GPU peuvent sembler occupes alors que les utilisateurs attendent encore, que les nouvelles tentatives augmentent ou que le debit de taches acceptees decoit. Cet article transforme la carte de ressources AI Performance Engineering V2 en Performance Evidence Ladder d'Optijara, une methode reproductible pour diagnostiquer les goulots d'etranglement d'inference, des traces de requetes aux preuves de service distribue.

Prochaine étape

Un projet à construire ?

Dites-nous ce dont vous avez besoin. Nous répondons avec un périmètre clair et un devis ferme.